En entradas anteriores hemos visto cómo integrarnos con los modelos de OpenAI y Google, pero hemos evitado entrar comentar en detalle parámetros de entrada adicionales que se incluyen en los servicios de llamada. Estos parámetros no son requeridos, pero pueden resultarnos útiles en ocasiones para afinar las respuestas. Vamos a dedicar esta entrada a explorar estos parámetros como se merecen.
La siguiente tabla es un resumen de los parámetros que vamos a examinar, y las APIs de qué modelos soportan. Además de OpenAI y Gemini, que ya hemos cubierto en anteriores entradas, tenemos una columna para Anthropic, que recientemente ha subido en popularidad con el lanzamiento de sus nuevos modelos Claude 3, y de los que hablaremos en el futuro próximo.
| OpenAI | Gemini | Anthropic | |
| Temperatura | ✔ | ✔ | ✔ |
| top K | ✔ | ✔ | ✔ |
| top P | ✔ | ✔ | |
| stopSequences | ✔ | ✔ | ✔ |
| logit_bias | ✔ | ||
| frequency_penalty | ✔ | ||
| presence_penalty | ✔ |
Temperatura
Supongamos que tenemos nuestro modelo, al cual hemos entrenado para que nos devuelva el siguiente carácter de un alfabeto reducido de diez letras (A … J). Dada una entrada, el modelo hace sus cálculos, y termina generando un vector, dando una puntuación a cada letra; a mayor la puntuación, mayor la probabilidad que el modelo le otorga a la aparición de ese carácter. El vector de puntuaciones (también llamadas logits) podría ser:
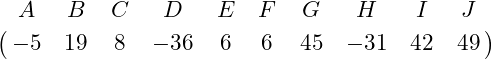
El problema es que este vector de puntuaciones es muy difícil de interpretar. Lo ideal que querríamos ahora es convertir estas puntuaciones en un vector probabilidades. Las características que este nuevo vector debe tener para poder interpretarse como probabilidades es que los valores de cada elemento estén entre 0 y 1, y la suma de todos los elementos sea 1.
Hay varias funciones que se pueden usar para convertir nuestras puntuaciones en probabilidades. Una de ellas es softmax, que sigue la formula:
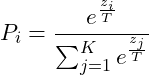
donde i = 1 … K (en este caso 10, que es el tamaño del vector).
La variable T es conocida como temperatura. Tiene el efecto de amplificar o suavizar la diferencia entre las opciones más probables y las demás. Las siguientes gráficas muestran para este ejemplo las probabilidades que softmax genera para distintas temperaturas:
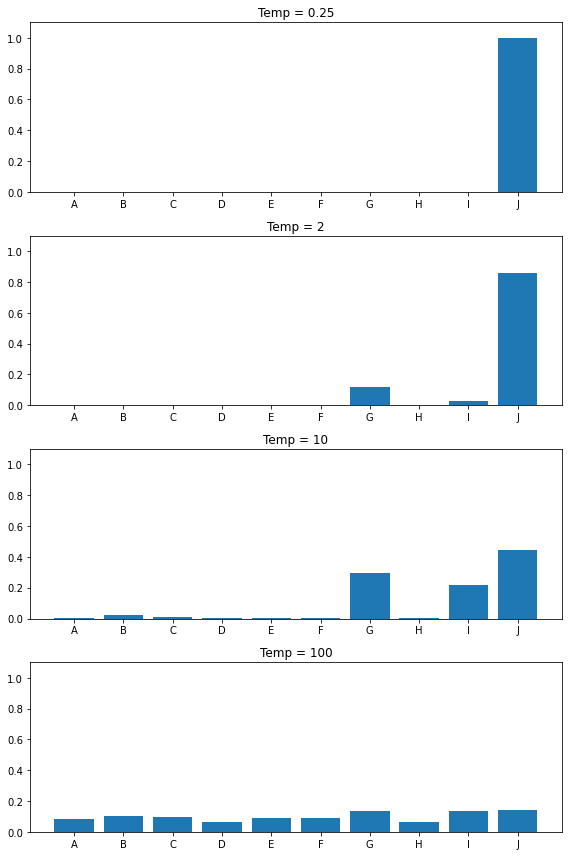
A valores bajos de la temperatura, la diferencia de probabilidad entre la opción con mayor puntuación y las siguientes es enorme. Conforme la temperatura aumenta, esa diferencia se va reduciendo, y a valores muy altos vemos que todas las opciones terminan teniendo probabilidades parecidas. En el extremo de una temperatura infinita, tendríamos la misma probabilidad para todas las opciones.
Esta es la razón por la que el valor de la temperatura hace que las respuestas del modelo sean menos deterministas (más creativas): mientras que a temperatura baja una opción con baja puntuación es extraordinariamente rara, a temperatura más alta es perfectamente posible que se incluya en la respuesta.
top K
El filtrado top K se basa en quedarnos con los K valores con mayor probabilidad, descartando el resto, y volviendo a normalizar (para que el nuevo vector resultante sume 1).
Usemos los valores del caso anterior como ejemplo. Aplicando softmax con T=10 nos da (redondeando) el siguiente vector de probabilidad:
![\[\[\bordermatrix{ & A & B & C & D & E & F & G & H & I & J \cr & 0.08 & 0.11 & 0.10 & 0.06 & 0.09 & 0.09 & 0.14 & 0.06 & 0.13 & 0.14 }\]](https://ojosdemochuelo.net/wp-content/ql-cache/quicklatex.com-047348390121e0e66beb9dbe77b545f1_l3.png)
Aplicamos ahora filtrado top K con valor 5 -nos quedamos con los 5 mayores, que vendrían a ser B, C, G, I y J- y volvemos a normalizar, con lo que queda:
![\[\[\bordermatrix{ & B & C & G & I & J \cr & 0.11 & 0.10 & 0.14 & 0.13 & 0.14 } \longrightarrow \[\bordermatrix{ & B & C & G & I & J \cr & 0.17 & 0.16 & 0.23 & 0.21 & 0.23 } \]](https://ojosdemochuelo.net/wp-content/ql-cache/quicklatex.com-d1a7887fe0112064ff045b808e0d2cf6_l3.png)
top P
La última opción de filtrado es top P. Es similar a top K, porque al aplicarlo nos quedaremos con varias de las opciones con mayor probabilidad y descartaremos el resto. La diferencia es que, en lugar de un número concreto de opciones (top K), lo que se mantiene es el conjunto mínimo de opciones, empezando por la más probable, cuya probabilidad acumulada supere el número dado.
Para verlo claro, reordenemos el vector de probabilidades que obtuvimos después del filtrado top K, y veamos las probabilidades acumuladas:
![\[\[\bordermatrix{ & J & G & I & B & C \cr & 0.23 & 0.23 & 0.21 & 0.17 & 0.16 } \longrightarrow \[\bordermatrix{ & J & G & I & B & C \cr & 0.23 & 0.46 & 0.67 & 0.84 & 1.00 } \]](https://ojosdemochuelo.net/wp-content/ql-cache/quicklatex.com-32a532ab07ab56cfb3dfbcdb654af685_l3.png)
En este caso, si el parámetro top P que eligiéramos fuera 0.5, el primer conjunto de elementos cuya probabilidad acumulada supera el valor sería el formado por J, G e I. Una vez seleccionados, el vector se vuelve a normalizar para obtener el resultado final:
![\[\[\bordermatrix{ & J & G & I \cr & 0.23 & 0.23 & 0.21 } \longrightarrow \[\bordermatrix{ & J & G & I \cr & 0.34 & 0.34 & 0.32 } \]](https://ojosdemochuelo.net/wp-content/ql-cache/quicklatex.com-511f17593efd7cfbf8dc79cd92fe69e3_l3.png)
Stop sequences
El parámetro stop sequences (stop para OpenAI, stopSequences para Gemini, stop_sequences para Anthropic) nos permite pasar una lista de secuencias de texto, que harán que la generación de texto se interrumpa inmediatamente en caso de encontrar alguna de ellos, y la secuencia en sí no se incluirá en la respuesta.
Veamos un ejemplo sencillo, ejecutando la siguiente llamada en Node.js:
import OpenAI from 'openai';

const client = new OpenAI();

const respuesta = await client.chat.completions.create({
    model: 'gpt-3.5-turbo',
    messages: [{ 'role': 'user', 'content': 'Dime quién eres y qué empresa te ha creado' }],
    stop: ['OpenAI']
});

console.log(respuesta.choices[0].message.content);
vemos que el mensaje se interrumpe cuando la respuesta iba a añadir la secuencia incluida en el parámetro stop (OpenAI):
Soy un asistente de inteligencia artificial creado porEsta funcionalidad puede resultar útil, por ejemplo, en casos en que esperamos una respuesta estructurada y con un final determinado; podemos asegurar que la generación termina al llegar a la cadena que queremos que sea el final, y de esa forma ahorrar tokens asegurando que la respuesta no incluye paja por la que tendríamos que pagar.
El problema que he encontrado a la hora de hacer uso de este parámetros es que la API de OpenAI y de Gemini no incluye ninguna indicación en la respuesta de si la respuesta se ha parado por haber encontrado alguna de las secuencias de terminación, o si ha sido porque el modelo se ha salido por la tangente y el final que esperábamos nunca ha llegado. La API de Anthropic, sin embargo, si que incluye un código de terminación específico para este caso, y nos indica además la secuencia de terminación que se ha encontrado. Así que punto positivo para Anthropic en este caso.
Logit_bias
Cuando empezamos a hablar del parámetro temperatura, comentamos que a las puntuaciones que le da el modelo a cada token antes de convertirlas a probabilidades se las llama logits. Tener eso en mente nos ayudará a entender el funcionamiento de este parámetro, que consiste en un objeto JSON que asocia una serie de tokens con un valor (bias, que se puede traducir como sesgo o tendencia) entre 100 y -100, que se usará para modificar la puntuación calculada por el modelo, modificando así las probabilidades (positiva o negativamente) de que dichos tokens terminen siendo incluidos en la respuesta.
La documentación de OpenAI no es demasiado específica sobre cómo exactamente se aplica este bias (menciona que depende del modelo), pero sí menciona que mientras que un bias de 1 o -1 afectarán (positiva o negativamente) la selección de un token, valores de 100 o -100 significan absoluta seguridad en la selección o exclusión de dicho token.
Veamos un ejemplo sencillo. Empezaremos con esta sencilla llamada en Node.js:
import OpenAI from 'openai';

const client = new OpenAI();
const respuesta = await client.chat.completions.create({
    model: 'gpt-3.5-turbo',
    messages: [{ 'role': 'user', 'content': 'En una frase, háblame de la empresa creadora de ChatGPT.' }]
});
console.log(respuesta.choices[0].message.content);
La empresa creadora de ChatGPT es OpenAI, una empresa de investigación en inteligencia artificial con sede en San Francisco, California.Poniendo la salida en Tokenizer vemos que OpenAI está compuesta de dos tokens, 5377 y 15836. De hecho, jugando un poco con Tokenizer vemos que los tokens varían si la palabra va precedida de espacios, o si cambia la capitalización:
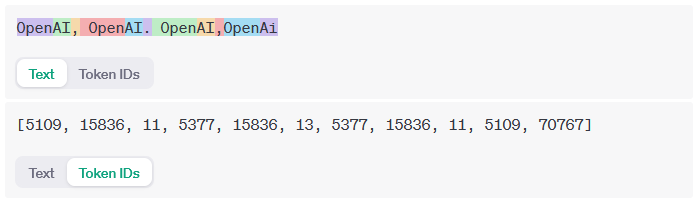
Hagamos ahora la misma llamada, pero poniendo un logit_bias de -100 para los tokens que hemos identificado correspondientes a OpenAI:
const respuesta2 = await client.chat.completions.create({
    model: 'gpt-3.5-turbo',
    messages: [{ 'role': 'user', 'content': 'En una frase, háblame de la empresa creadora de ChatGPT.' }],
    logit_bias: { 5109: -100, 15836: -100, 5377: -100, 70767: -100 }
});
console.log(respuesta2.choices[0].message.content);
Ejecutando múltiples veces, estas son varias de las respuestas que he obtenido:
ChatGPT fue creado por la empresa abierta e innovadora que es la compañía especializada en IA y lenguaje natural llamada Pile.
---
La empresa creadora de ChatGPT es una startup de tecnología con sede en California que se enfoca en el desarrollo de soluciones de inteligencia artificial para mejorar la comunicación y la interacción entre humanos y computadoras.
---
ChatGPT fue creada por la empresa tecnológica estadounidense "OPEN AI".
Aparte de que sea gracioso ver al pobre GPT teniendo que hacer el pino-puente para arreglárselas y dar una repuesta, es importante anotar que la primera de las respuestas es claramente falsa. Así que se debe tener en cuenta que el uso de este parámetro puede no solo hacer que el modelo evite determinadas palabras, sino que puede también afectar a la fiabilidad de las respuestas.
Si volvemos a ejecutar, pero esta vez modificamos el bias de 15836 para que sea +100 en lugar de -100, esta es la salida:
AIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIAIFrequency penalty
Frequency penalty (penalización por frecuencia) es un número entre 2 y -2, y nos permite reducir (o aumentar, en el caso se un valor negativo) las repeticiones de tokens en la respuesta. La forma en la que lo hace es modificando el valor de los logits de la siguiente manera:
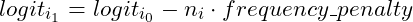
donde  representa el valor original del logit, y
 el número de veces que ese token ya había aparecido en la respuesta.
Por tanto, el valor efectivo de la penalización va aumentando según dicho token va apareciendo más veces en la respuesta.
Presence penalty
Presence penalty (penalización por presencia) es similar a frequency penalty en que también es un numero entre 2 y -2, y que también modifica lo logits para penalizar las repeticiones, pero lo hace de forma distinta:
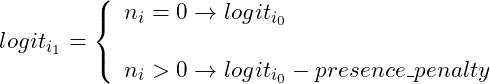
Es decir, que la penalización por presencia es siempre la misma cuando un token dado ya ha aparecido en la respuesta al menos una vez.