Las dos primeras entradas de este blog han estado dedicadas al uso del API de OpenAI. Al fin y al cabo OpenAI, con el lanzamiento de sus modelos GPT, ha sido el principal responsable del boom de la IA que estamos viviendo, y por tanto era la opción lógica para empezar. Sin embargo, no vamos a limitar nuestra exploración a los modelos de OpenAI, especialmente habiendo ahora mismo tantas opciones accesibles a los desarrolladores. En esta entrada trataremos sobre los modelos Gemini de Google.
Gemini es una familia de modelos multimodales (lo cual quiere decir que han sido entrenados para trabajar tanto con texto como con imágenes y sonidos), de los cuales hasta ahora se han anunciado tres miembros:
- Gemini Ultra: El más potente de todos, y considerado de un nivel similar a GPT 4. Se encuentra disponible para usar mediante API desde hace poco, y también se puede usar desde la aplicación de chat de Gemini con suscripción a Gemini Advanced.
- Gemini Pro: Un modelo algo menos avanzado, de nivel comparable a GPT 3.5. Disponible a través de API, y en la versión gratuita de la aplicación de chat.
- Gemini nano: El modelo más pequeño de la familia, diseñado para ejecutarse en dispositivos móviles.
La clave de API
Como para casi cualquier API que queramos usar (ya sea de IA o no) lo primero que necesitaremos será conseguir una clave de API con la que identificarnos en nuestras llamadas. En el caso de Gemini, el primer paso es crearnos una cuenta en Google (si es que no la tenemos ya), para después dirigirnos a Google AI Studio, aceptar los términos de servicio, y elegir la opción «Get API key».
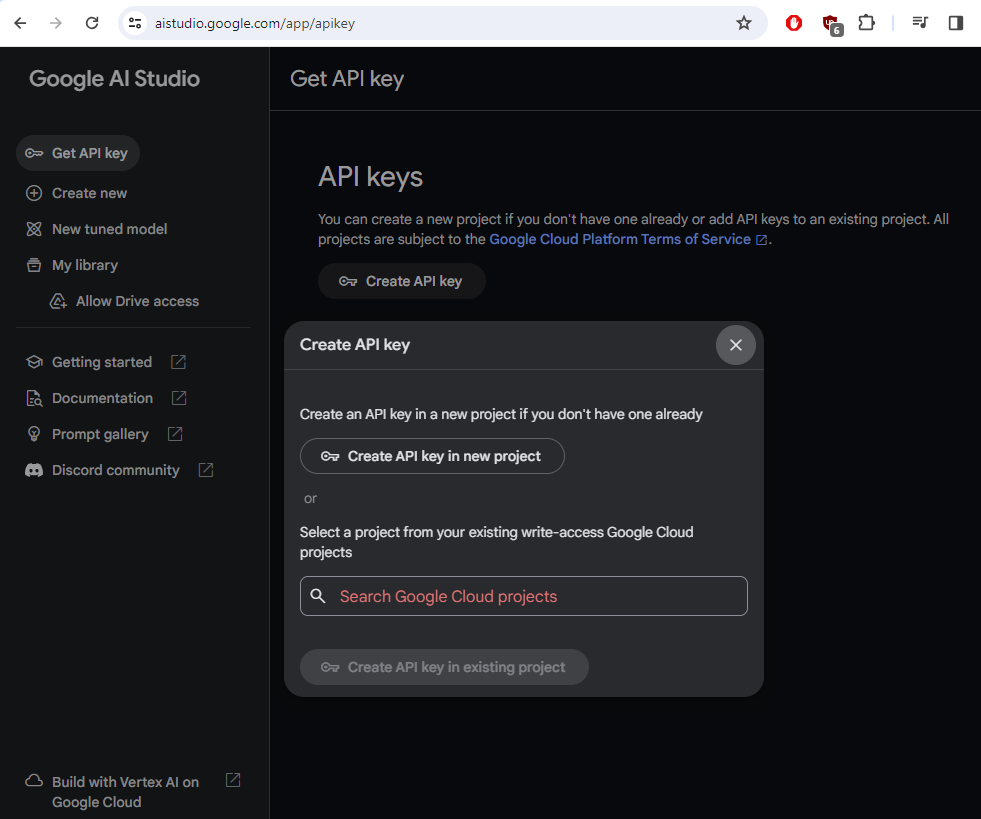
Google AI Studio forma parte del ecosistema de Google Cloud, y al ir al crear la clave nos preguntará si ya tenemos un proyecto de Google Cloud como parte del cual queramos crear nuestra clave. Si así lo queremos podemos elegir un proyecto existente, pero en caso contrario bastará con elegir la opción «Create API in new project» para que nos genere nuestra clave en un proyecto nuevo. En la pantalla siguiente ya tendremos nuestra clave generada que podremos usar para llamar la API de Gemini.
Merece la pena mencionar que Google AI Studio es una herramienta interesante con la que merece la pena la menos cacharrear un rato, ya que nos permite jugar de manera visual con los parámetros de las llamadas al model y probar nuestras llamadas interactivamente.
A diferencia de lo que tuvimos que hacer con OpenAI, no vamos a necesitar en este caso hacer ningún pago a Google para poder hacer llamadas básicas a la API, y ni siquiera vamos a tener que configurar ninguna forma de pago. Google permite hacer gratuitamente llamadas a Gemini PRO, con un límite de 60 llamadas por minuto.
Vamos a estrenar nuestra clave de API haciendo una llamada por curl para obtener la lista de modelos disponibles:
curl https://generativelanguage.googleapis.com/v1beta/models?key=clave-de-apiSi todo ha ido bien recibiremos una lista con los modelos que Google pone ahora mismo a nuestra disposición, por ejemplo este, que es el que vamos a utilizar:
{
      "name": "models/gemini-pro",
      "version": "001",
      "displayName": "Gemini 1.0 Pro",
      "description": "The best model for scaling across a wide range of tasks",
      "inputTokenLimit": 30720,
      "outputTokenLimit": 2048,
      "supportedGenerationMethods": [
        "generateContent",
        "countTokens"
      ],
      "temperature": 0.9,
      "topP": 1,
      "topK": 1
}
Chatbot cascarrabias con Gemini
Para explorar la forma de usar la API de Gemini, empezaremos por reimplementar a nuestro viejo amigo, el chatbot cascarrabias con Gemini. Lo haremos directamente con streaming y control de tokens, ambas funcionalidades también soportadas por la API de Gemini. El código completo de las versiones para Python y Node.js se puede encontrar en GitHub.
Google proporciona librerías en múltiples lenguajes para acceder a la API de Gemini. Las librerías para Python o Node.js se instalan de la siguiente manera:
Python
pip install -q -U google-generativeaiNode
npm install @google/generative-aiCon la librería instalada, basicamente necesitaremos invocar tres servicios: instanciar el modelo, obtener las respuestas y contar tokens. Veremos en detalle como hacerlo:
Instanciación del modelo
El modelo se instancia invocando el servicio GenerativeModel, como se muestra en el siguiente ejemplo en Python:
gemini = genai.GenerativeModel(model_name="gemini-pro",
            generation_config=generation_config,
            safety_settings=safety_settings)
El primer parámetro, model_name (model en la versión Node), es el único obligatorio y sirve para identificar el modelo que queremos instanciar. En este caso, el modelo Gemini Pro que vimos antes al llamar a la lista de modelos.
El segundo parámetro, generation_config, sirve para ajustar varios parámetros del modelo, y tiene, a modo de ejemplo, la siguiente forma:
generation_config = {
    "candidate_count": 1,
    "max_output_tokens": 2048,
    "temperature": 0.9,
    "top_p": 1,
    "top_k": 1,
}
Los parámetros temperature, top_p y top_k son útiles para ajustar como de predecible o creativa será la respuesta del modelo; en una próxima entrada veremos en más detalles qué significan exactamente estos parámetros y cómo ajustarlos. Candidate_count actualmente no permite valores distintos de 1, pero su idea (quizá en el futuro) es que se pueda pedir al modelo que genere varias respuestas candidatas. Max_output_tokens se puede usar para limitar el número máximo de tokens en la respuesta.
Por último, el parámetro safety_settings, nos permite modificar las configuraciones de seguridad que se incluyen en el modelo, que nos pueden permitir filtrar (o no) contenidos peligrosos o explícitos. Por ejemplo, si quisiéramos eliminar todos los controles de seguridad y permitir cualquier tipo de contenido, podríamos usar la siguiente configuración:
safety_settings = [
    {
        "category": "HARM_CATEGORY_HARASSMENT",
        "threshold": "BLOCK_NONE"
    },
    {
        "category": "HARM_CATEGORY_HATE_SPEECH",
        "threshold": "BLOCK_NONE"
    },
    {
        "category": "HARM_CATEGORY_SEXUALLY_EXPLICIT",
        "threshold": "BLOCK_NONE"
    },
    {
        "category": "HARM_CATEGORY_DANGEROUS_CONTENT",
        "threshold": "BLOCK_NONE"
    },
]
Obtener respuesta del modelo
De forma similar al servicio chat completions para la API de OpenAI, el servicio generateContent de la API de Gemini es el que utilizaremos para mandar mensajes al modelo y obtener respuestas. El principio de funcionamiento es el mismo: en conversaciones, deberemos mandar el historial completo de la conversación hasta ese punto, ya que cada llamada es independiente y no tiene memoria.
El parámetro de entrada obligatorio es una lista de mensajes conteniendo todo el historial de la conversación hasta ese punto. De forma similar a la API de OpenAI, cada mensaje va marcado por un parámetro role que indica si fue originado por el usuario o por el modelo. A diferencia de OpenAI, sin embargo, Gemini sólo entiende dos roles: user y model; no tiene un tercer rol comparable al system de OpenAI, que nos permita dar contexto adicional a la conversación. Con Gemini, la única forma que tendremos de darle algo de contexto al modelo es insertando un intercambio de mensajes ficticio entre user y model antes de empezar. Como muestra, esta es la forma en la que inicializaremos la lista de mensajes dando contexto sobre el comportamiento que esperamos del modelo, en Python:
mensajes = [{'role':'user', 'parts': ['Eres un viejo gruñón y cascarrabias ... etc']},
            {'role':'model', 'parts': ['Vale']}]
El formato del objeto de cada mensaje es un poco distinto en Node. Esta sería la forma de inicializar la misma lista de mensajes en Node:
let mensajes = [
 { 'role': 'user', 'parts': [{ 'text': 'Eres un viejo gruñón y cascarrabias ... etc' }]},
 { 'role': 'model', 'parts': [{ 'text': 'Vale' }]}
];
La lista de mensajes la mandamos al servicio generateContent para obtener la respuesta. Adicionalmente, si queremos hacer streaming de la respuesta, en Node hay dos servicio distintos, generateContent y generateContentStream, con y sin streaming, mientras que en Python pasaremos el parámetro Stream a True al servicio para activar streaming:
respuesta = gemini.generate_content(mensajes, stream=True)Para uso específico en chats, las librerías tienen otros servicios llamados start_chat y send_message (startChat y sendMessage en Node) que facilitan la tarea, ya que gestionan automaticamente el historial, pero al final terminan ejecutando llamadas al servicio generateContent de la API. Yo para los ejemplos de esta entrada he preferido usar el servicio generateContent directamente.
Contar tokens
La API de Gemini incluye un servicio para contar tokens, a diferencia de OpenAI, donde para contar tokens usamos una librería externa (tiktoken). Dicho servicio recibe de entrada una lista de mensajes en el mismo formato en el que se envían a generateContent.
Por ejemplo, para contar los tokens de los dos últimos mensajes de la lista, en Python sería:
gemini.count_tokens(mensajes[-2:]).total_tokensAl ser countTokens una llamada a la API en lugar de un calculo realizado localmente por una librería, para ahorrar operaciones de red, en el código de chatbot cascarrabias he optado por hacer una única llamada para obtener los tokens del último intercambio (pregunta y respuesta) de una sola vez.
GPT contra Gemini
Ahora que ya hemos visto cómo usar la API de Gemini, y con el conocimiento que ya teníamos de hacer lo mismo con OpenAI, ¡juntémoslo todo y pongamos a los dos modelos a discutir entre ellos!
Claramente influenciado por las elecciones presidenciales americanas que tendrán lugar este año, he optado por asignar a GPT el rol de candidato presidencial demócrata, y a Gemini el de republicano, y lanzarlos al ruedo para discutir sobre la sanidad.
El código completo en Python y Node.js lo puedes ver en GitHub, pero la idea es la misma que en una aplicación de chat, con la diferencia de que en lugar de haber captura de entrada del usuario, el mensaje de salida de cada modelo servirá de entrada para el otro. A alto nivel lo que hará el código es:
- Instanciar ambos modelos e inicializarlos de manera similar, explicándoles que se encuentran en un debate y el rol que deben interpretar. Para OpenAI usamos un mensaje con rol system, mientras que con Gemini lo haremos con un mensaje-respuesta como hemos explicado previamente en esta entrada. Mantendremos dos listas de mensajes separadas, una para cada modelo.
- Empezamos invocando al modelo para uno de ellos (en este caso, GPT), capturamos la salida y la introducimos en la lista de mensajes de GPT con rol assistant, y en la de Gemini con rol user.
- Invocamos a Gemini con su lista de mensajes, y guardamos la salida, de nuevo en ambas listas, pero con los roles invertidos.
- Iteramos el número de veces que deseemos.
Por simplificar, he optado por no incluir control de número de tokens, y limitado el número de iteraciones a 5.